过刊目录

  • 全选
    |
    目录
  • 目录
    2026, 70(17): 0-0.
    PDF全文 ( )   可视化   收藏
  • 专题:大语言模型支持下的文化与典籍计算人文研究
  • 专题:大语言模型支持下的文化与典籍计算人文研究
    黄水清
    2026, 70(17): 3-3.
    PDF全文 ( )   可视化   收藏
  • 专题:大语言模型支持下的文化与典籍计算人文研究
    张卫, 高鑫, 张予歌
    PDF全文 ( )   可视化   收藏
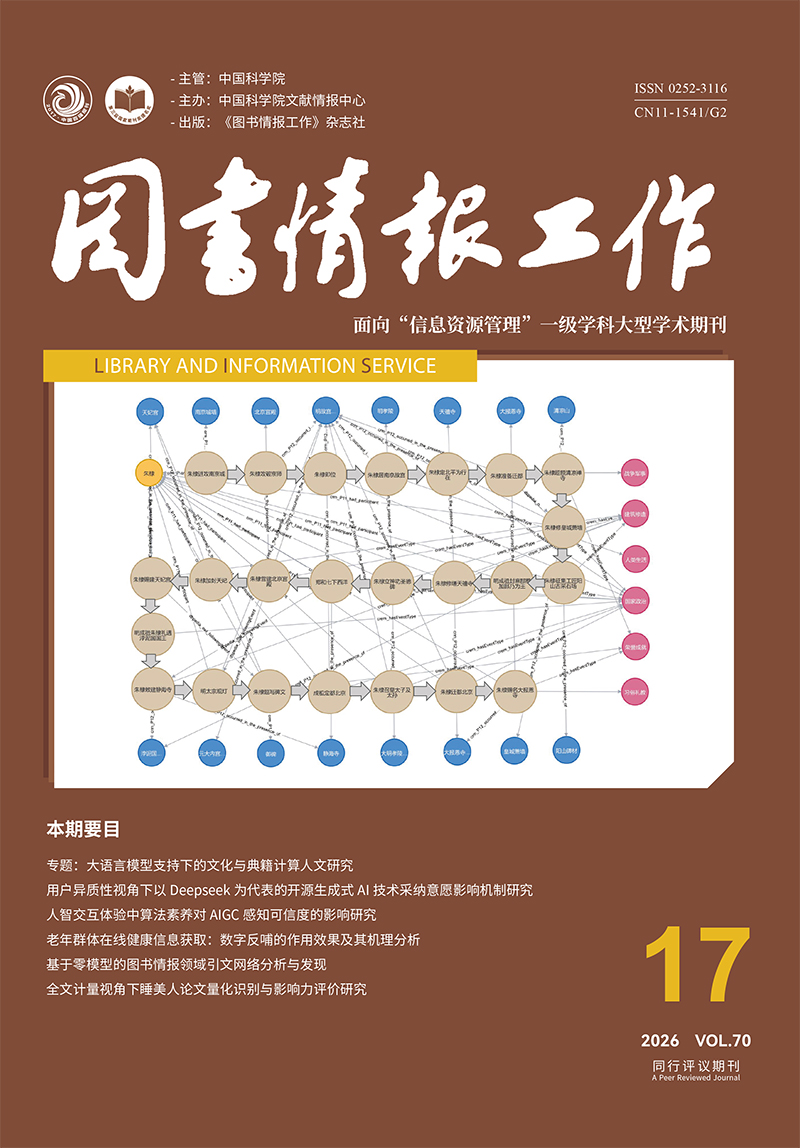
    [目的/意义]文化遗迹叙事文本是我国重要的文物数据资源,利用AIGC技术挖掘与组织叙事文本内的事件语义特征,对于文化遗产数字记忆保护与开发具有重要意义。[方法/过程]在大语言模型强化学习驱动下提出基于事件本体的文化遗迹叙事文本语义组织方法。首先,综合专家智慧与文本特征进行事件概念揭示与知识单元重组,归纳遗迹叙事文本中核心元数据形成遗迹事件本体;基于DeepSeek深度思考范式进行事件抽取冷启动以获取伪标签,引入人智协同思维对各任务问答语料进行质量优化;重点针对事件抽取的任务框架设计高效自适应的奖励函数,并通过组内相对优势计算探索事件提及抽取、事件分类、事件论元识别等大模型强化学习的有效性。[结果/结论]经过群体相对策略优化的DeepSeek-R1-Distill-Qwen-32B蒸馏模型分别在事件提及抽取(BLEU_1=80.21%、ROUGE-1-F1=84.64%)与事件论元识别(F1=78.90%)任务取得最佳实践,强化后的QwQ-32B在事件分类任务上更具优势(ACC=86.09%);经过实体消歧与共指消解能够进一步优化事件知识图谱的质量,从历史情节分析、人物知识谱系、时空耦合分析方面实现文化遗迹数字叙事服务。
  • 专题:大语言模型支持下的文化与典籍计算人文研究
    赵文华, 叶文豪, 杨帆, 刘浏
    PDF全文 ( )   可视化   收藏
    [目的/意义]古籍文献的命名实体识别是正确分析处理古汉语文本的基础步骤,也是深度挖掘和组织人文知识的关键支撑。本研究旨在探究大语言模型在古籍命名实体识别应用的技术路径,以深度挖掘和组织古籍中蕴含的丰富人文知识,为古籍数字化资源的智能开发、文化传承与学术研究提供技术支撑。[方法/过程]首先,制定统一标注规范,结合自动识别与人工精校策略构建高质量《二十四史》古现对照命名实体识别专用语料库;其次,以Qwen系列和DeepSeek-R1蒸馏模型为基座,采用指令监督微调(supervised fine-tuning,SFT)和群体相对策略优化的强化学习(group relative policy optimization,GRPO)技术进行领域微调,重点增强模型对古汉语语法、语义及上下文的理解能力;最后,设计严谨实验,使用多种评测指标系统评估模型在实体识别精度、鲁棒性和泛化能力上的综合性能。[结果/结论]实验结果表明SFT整体表现更优且稳定,性能随模型参数量增大而提升;GRPO效果高度依赖基座模型能力,仅在DeepSeek-R1蒸馏模型上取得最优结果(ROUGE-1达0.81),其他模型GRPO后性能可能衰减,表明GRPO存在冷启动风险。本研究为古籍命名实体识别提供了基于先进大语言模型的有效路径,构建的高质量语料库与优化模型为古籍数字化与知识化奠定了重要基础。
  • 专题:大语言模型支持下的文化与典籍计算人文研究
    叶文豪, 赵文华, 王希羽, 刘浏
    PDF全文 ( )   可视化   收藏
    [目的/意义]大语言模型为古诗词机器翻译带来了直接助力。通过考察和对比大语言模型在古诗词翻译中的表现,尤其关注垂直领域大模型、训练集规模和朝代对翻译效果的影响,以期为未来古诗词翻译模型的优化提供参考。[方法/过程]使用整体和分类两种方法构建指令微调数据集,以BLEU、ROUGE作为评估指标并结合智能体(Agent)进行评估,选择经过古诗词数据预训练与微调的Qwen1.5-7B-poem模型与Qwen、Baichuan系列大语言模型。通过比较各模型在不同规模训练集下的翻译效果,研究分析大模型对语言特征和翻译规则的学习能力。此外,对比不同朝代诗词的翻译效果,以评估古诗词风格对翻译质量的影响。[结果/结论]结果表明,随着微调数据规模的增加,各模型的翻译准确性和流畅度都得到显著提高,表现出其对古诗词的语言特征与翻译规则的学习能力,符合大语言模型的规模效应。Qwen1.5-7B-poem表现最为突出,表明垂直领域大模型在领域性任务中更能发挥规模效应。此外,不同朝代的诗词翻译效果存在显著差异,表明语言的时代特点以及诗词的时代风格对模型翻译性能具有影响。大语言模型在古诗词翻译中的表现受训练数据集规模和朝代等多种因素的影响,未来研究可以进一步优化这些因素,以提升模型的泛化能力和翻译质量。
  • 研究论文
  • 研究论文
    马续补, 周冰芮, 秦春秀, 林强
    PDF全文 ( )   可视化   收藏
    [目的/意义]以DeepSeek为代表的开源生成式AI技术正加速技术普惠进程,然而用户异质性导致其技术采纳路径出现显著分化,因此亟需克服传统模型的同质性用户假设。以用户异质性作为核心理论视角与创新点,能够系统解构开发者、企业用户、普通用户及探索型用户的技术采纳驱动机制。[方法/过程]整合技术接受模型(TAM)、统一技术接受与使用理论(UTAUT)及信息生态理论,基于用户在“角色—能力—需求”三个维度的差异,构建开源生成式AI的“场景—技术—生态”分析框架。共收集391份有效问卷数据,采用结构方程模型(SEM)分析指标间的因果关系,并结合模糊集定性比较分析方法(fsQCA)挖掘四类用户的组态路径差异。[结果/结论]研究发现,开发者的技术采纳意愿以技术效率与隐私权衡驱动,呈现“全维驱动”与“风险回避”两条路径;企业用户接受高度场景化,追求“社群赋能”“合规优先”等四类需求;普通用户依赖自身体验,追求轻量化体验;探索用户关注轻量化体验与新颖性。结果表明,用户异质性显著影响技术采纳路径,需通过差异化治理策略,推动开源生成式AI的普惠化应用。
  • 研究论文
    刘佳, 李佳忆, 李贺
    PDF全文 ( )   可视化   收藏
    [目的/意义]探究人智交互体验中用户算法素养对AIGC感知可信度的影响机制,以优化用户体验、增强其对AIGC技术的信任与接纳程度。[方法/过程]基于启发—系统式模型与“计算机即社会行动者”理论,结合拟人化表达、同理心感知等社会属性,采用涵盖算法知识、算法意识、算法评估、算法应对和算法创造五个维度的算法素养体系,构建算法素养对AIGC感知可信度影响的理论模型,采用结构方程模型进行实证分析。[结果/结论]研究发现,算法素养通过强化用户感知信息质量促使用户采用系统式处理,从而显著提升感知可信度;然而,其通过削弱用户感知功能质量抑制启发式处理,进而对感知可信度产生负向影响,性别、学历等用户特征未显著调节该路径。此外,算法知识、算法评估与算法创造正向影响用户感知信息质量;算法意识与算法知识负向影响用户感知功能质量;算法知识与算法应对则正向影响用户感知AI道德。
  • 研究论文
    袁静, 万璐, 孙倬
    PDF全文 ( )   可视化   收藏
    [目的/意义]探讨数字反哺对老年群体在线健康信息获取的作用效果及其机理,为破解老年数字贫困和提升老年群体数字健康素养提供参考。[方法/过程]设计信息搜寻实验任务,招募42位老年人参与准实验,对实验组与对照组的任务完成情况进行比较,结合访谈数据并采用扎根理论编码分析,通过“个体干预”与“资源支持”双路径探究数字反哺对老年群体健康信息获取效果的作用机理。[结果/结论]对于简单任务,数字反哺能够提升老年群体健康信息获取效率与质量;对于复杂任务,数字反哺虽然作用效果更强,能显著提升健康信息获取质量与准确度,但因耗时过多导致效率有所下降,呈现出“慢决策、高质量”特征。数字反哺通过“个体干预”与“资源支持”双路径作用于老年群体,重构用户认知和素养能力,改善用户健康行为决策,进而提升健康信息获取效果。
  • 研究论文
    陈洪侃, 田逸凡, 步一
    PDF全文 ( )   可视化   收藏
    [目的/意义]零模型是网络分析中的重要工具,可用于控制潜在混杂因素,减少研究结论偏差。本文旨在提出高效的随机置换策略,以提升零模型在大规模网络分析中的可行性。[方法/过程]系统梳理零模型的基本原理与方法,讨论现有方法的优缺点,并针对引文网络中的常见约束(如考虑节点属性、优先连接性、无自环等),基于Fisher-Yates置换算法提出一系列高效的随机化算法。本文进一步优化置换策略,结合随机值优化算法和大根堆数据结构,在保证严格约束条件的同时将时间复杂度降至O(MlogM)。此外,通过图情领域期刊的引用偏好分析,对比不同零模型的研究结论差异,验证所提方法的有效性。[结果/结论]研究表明,零模型的选择需与研究问题匹配:简单模型易产生“稻草人”结论,而复杂模型可能导致过度拟合。不同零模型还可能导致结论差异,因此实际应用中需结合研究背景谨慎选择。本文讨论了常见的三种约束条件,未来可进一步探讨特殊约束以及不同约束的组合。
  • 研究论文
    王旭, 石冬阳, 薛宇菲, 赵鸿玉
    PDF全文 ( )   可视化   收藏
    [目的/意义]从全文计量视角开展睡美人论文量化识别与影响力评价研究,为睡美人论文的量化识别提供新型识别指标与方法,助力高价值睡美人论文发挥科学发展的推动作用。[方法/过程]以Web of Science数据库中管理学和计算机科学在1996—2014年发表的论文为数据来源。首先,使用改进后的YCPA (Yearly Cumulative Percentage of Attention)指数量化识别睡美人论文,并对识别效果进行检验。其次,从全文计量视角出发,以学术影响力、社会影响力、感知影响力三个维度构建睡美人论文影响力评价指标体系。再次,采用熵权法进行单维度和综合评价实证,并利用BP神经网络模型对评价结果进行验证。最后,通过分析睡美人论文特征学科差异性评价结果,分析睡美人论文沉睡和唤醒的特征。[结果/结论]研究表明:①改进后的YCPA指数具有良好的睡美人论文识别效果。②构建的全文计量视角下睡美人论文影响力评价指标体系实现了有效的单维度评价和综合评价。其中,社会影响力对其综合影响力正向影响最强;团队力量、研究跨学科性、期刊影响力显著提升睡美人论文学术影响力;官方政策提及、社交平台大众讨论显著提升社会影响力;施引文本的提及情感显著提升感知影响力。③分析了管理学和计算机科学睡美人论文沉睡和唤醒的特征。
  • 研究论文
    刘运梅, 李冉, 盛小平
    PDF全文 ( )   可视化   收藏
    [目的/意义]在学术不端事件频发背景下,期刊的过度自引现象日益隐蔽,传统量化指标难以识别期刊的过度自引行为,亟需内容语义层面的细粒度分析,为优化学术生态系统治理提供决策依据。[方法/过程]基于引文内容语义分析,构建包含引用位置、引用距离、引用深度、引用功能、引用强度及语义相似度的六维度自引行为标注框架。以被SSCI剔除的过度自引期刊Library Hi Tech和同领域权威期刊Information & Management为样本,通过对比分析揭示过度自引的微观特征。[结果/结论]研究发现:第一,过度自引多集中于引言与讨论等非核心位置,表现为短距离、浅层次、单一功能、语义关联薄弱;第二,合理自引在方法中分布更广,功能多样,且语义关联性显著更高。研究揭示期刊过度自引“非核心位置—浅层引用—密集引用—功能单一—低语义关联”的机械化引用特征,为期刊及论文维度的异常自引行为的智能化监测提供理论依据与方法支撑。

  • 研究论文
    戴艳清, 祝佳纯
    PDF全文 ( )   可视化   收藏
    [目的/意义]当前普惠性非基本公共文化服务政策正处于城市试点阶段的政策建构期,政策实施过程中暴露出诸多困境,亟需通过系统性研究破除政策执行难点。[方法/过程]运用深度访谈、文献调研等方法,结合史密斯模型探讨普惠性非基本公共文化服务政策实践困境。[结果/结论]为突破政策现有执行困境,建议从以下方面着手:理想化政策层面应协调冲突条款,制定并完善可推广性的优惠收费政策;执行机构层面,需通过成本补偿与绩效奖励激活公共文化机构执行动力,并以包容性准入机制吸纳社会力量;目标群体层面建议构建三级供给模式提升文化参与度,并引导公众合力监督;环境层面,应优化资金配置,培育文化消费新观念等。
  • 研究论文
    俞寅天, 曹高辉, 董焕晴
    PDF全文 ( )   可视化   收藏
    [目的/意义]为应对网络暴力治理过程中响应滞后的难题,提升对网络暴力苗头性、倾向性问题的预警与干预能力,提出一套面向早期网暴现象的识别框架。[方法/过程]基于群际情绪理论,综合运用文本倾向性分析和群体意图研判方法,识别早期网暴演化过程中的关键节点,构建早期网暴现象场景并提出分阶段干预策略。[结果/结论]构建涵盖六类情境的早期网暴现象场景体系,并结合案例验证识别准确性与干预方案的可行性,提出具有针对性与可操作性强的干预策略,为政府优化风险预警与制度设计、平台提升内容识别与响应能力提供实证支持与策略建议。