×
模态框(Modal)标题
在这里添加一些文本
关闭
关闭
提交更改
取消
确定并提交
×
模态框(Modal)标题
×
下载引用文件后,可以用常见的文献管理软件打开和编辑,包括: BibTex, EndNote, ProCite, RefWorks, and Reference Manager.
选择文件类型/文献管理软件名称
RIS (ProCite, Reference Manager, EndNote)
BibTeX
选择包含的内容
仅文章引用信息
引用信息及摘要
导出
高级检索
|
图表检索
导航切换
图书情报工作
首页
投稿指南
选题指南
目标和范围
论文写作模板
编辑出版流程
欢迎订阅
过刊浏览
出版政策
作者署名规定
预印本政策声明
出版伦理声明
数据共享政策
AI政策声明
学术不端处理办法
外审专家审稿规定
费用及知识产权政策
相关政策
诚邀合作
广告
研究会
学术会议
知识管理论坛
关于我们
期刊介绍
获奖情况
期刊团队
联系我们
English
作者投稿
编辑办公
专家审稿
下载专区
数据提交
《图书情报工作》
更多
2026年, 70卷, 第21期
刊出日期:2026-11-05
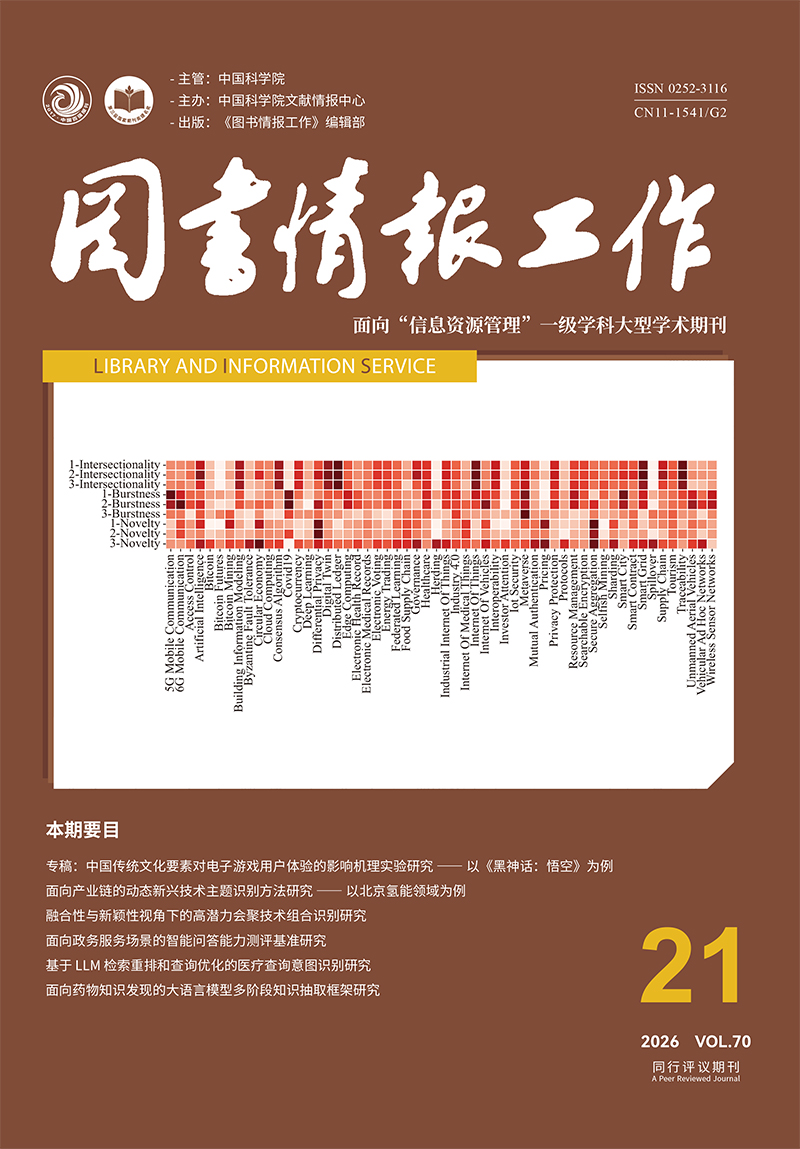
本期要目
中国传统文化要素对电子游戏用户体验的影响机理实验研究——以《黑神话:悟空》为例(苏文成, 朱雯雯, 卢章平, 潘颖, 孙莹琳)
面向产业链的动态新兴技术主题识别方法研究——以北京氢能领域为例(邓明荣, 韩楚琦, 王嘉怡, 杨冠灿)
融合性与新颖性视角下的高潜力会聚技术组合识别研究(虞逸飞, 黄颖, 叶冬梅, 张琳)
面向政务服务场景的智能问答能力测评基准研究(黄钰婷, 邵扶天, 宋姗姗, 黄璜)
基于LLM检索重排和查询优化的医疗查询意图识别研究(韩普, 刘森嶺)
面向药物知识发现的大语言模型多阶段知识抽取框架研究(康宏宇, 李姣, 李勤, 侯丽)
当期目录
推荐文章
正在组织的专辑
点击排行
2026年, 70卷, 第21期
刊出日期:2026-11-05
封面文件
目录文件
全选
|
封面
Select
封面
封面
2026, 70(21): 0-0.
摘要
(
)
PDF全文
(
)
可视化
收藏
目录
Select
目录
目录
2026, 70(21): 1-2.
摘要
(
)
PDF全文
(
)
可视化
收藏
专稿
Select
专稿
中国传统文化要素对电子游戏用户体验的影响机理实验研究——以《黑神话:悟空》为例
苏文成, 朱雯雯, 卢章平, 潘颖, 孙莹琳
2026, 70(21): 3-15.
https://doi.org/10.13266/j.issn.0252-3116.2026.21.001
摘要
(
)
PDF全文
(
)
可视化
收藏
[目的/意义]
探究中国传统文化要素对电子游戏用户体验的影响机理,为传统文化融入电子游戏设计提供理论参考与实践策略,进而探索传统文化在当代青年群体中的有效传播路径。
[过程/方法]
以《黑神话:悟空》为对象,整合传统文化技术性传播、符号互动及用户体验理论,通过眼动追踪技术开展实验研究,组织被试完成《黑神话:悟空》游戏序章及战斗事件,采集人物、景观、战斗、服饰四大兴趣区的注视次数和总注视时间,并结合传统文化要素评价感知问卷与GEQ量表数据进行相关性以及回归分析。
[结果/结论]
人物与服饰视觉符号主导感官体验,人物、景观与战斗动态符号驱动交互体验,战斗符号文化解码触发价值体验;服饰与战斗注视指标对用户能力感知有显著解释力,且共同构建沉浸体验基础,同时揭示心流、情绪维度与眼动指标无显著关联的深层原因。
研究论文
Select
研究论文
面向产业链的动态新兴技术主题识别方法研究——以北京氢能领域为例
邓明荣, 韩楚琦, 王嘉怡, 杨冠灿
2026, 70(21): 16-33.
https://doi.org/10.13266/j.issn.0252-3116.2026.21.002
摘要
(
)
PDF全文
(
)
可视化
收藏
[目的/意义]
针对传统静态主题分析在刻画新兴产业技术演化时对动态性和产业关联度关注的不足,以及现有方法多采用基于全局数据的后向视角回溯式分析导致的幸存者偏误的问题,融合“产业链—技术主题—动态演化”三维视角,提出一种面向产业链的动态新兴技术主题识别与演化分析方法,并以北京氢能产业为例开展实证研究,为政策制定、资源配置及跨产业方法迁移提供理论与实践参考。通过对北京氢能产业2010—2024年专利数据的实证检验,旨在验证基于前向视角的动态技术主题识别框架有效性,为政策制定、资源配置和跨产业方法迁移提供理论与实践参考。
[方法/过程]
构建融合产业链视角的动态新兴技术主题识别框架,包括技术主题识别与优化、产业链体系构建、主题与产业链环节映射。方法上创新性地引入前向视角与后向视角两种动态观测策略,分别对应演化调优和全局调优策略;基于主题相似度网络构建跨期演化路径,运用河流图可视化技术揭示技术主题的时序演化特征,并从演化模式识别、演化阶段划分和关键主题识别三个维度进行多维演化分析。
[结果/结论]
实证发现北京氢能技术演化经历技术分散期、技术融合期到系统整合期三个阶段,识别出持续性演变和断裂性演变两种典型演化模式。其中,关键主题如“化工分离与重整技术”和“氢能系统集成技术”构成技术创新主干路径,而“氢能无人机系统技术”等体现技术跳跃式突破特征。技术主题在产业链上呈现上游制氢技术路线多元化、中游储运相对集中的分布与下游应用环节最为密集,反映产业向集成化、规模化发展趋势。所构建的融合前向视角与后向视角的方法框架在避免幸存者偏误、捕捉技术演化不确定性方面具有显著优势,为新兴产业技术演化提供了系统化、可复用的分析工具。
Select
研究论文
融合性与新颖性视角下的高潜力会聚技术组合识别研究
虞逸飞, 黄颖, 叶冬梅, 张琳
2026, 70(21): 34-48.
https://doi.org/10.13266/j.issn.0252-3116.2026.21.003
摘要
(
)
PDF全文
(
)
可视化
收藏
[目的/意义]
技术会聚通过跨领域知识重组持续催生新技术路径,已成为推动产业结构升级与技术范式演进的重要机制。系统识别具备高发展潜力的会聚技术组合,对于前瞻性技术机会发现与创新资源配置具有重要理论与实践价值。
[方法/过程]
立足技术会聚的本质特征,从技术融合性与技术新颖性两个核心维度出发,构建多指标的会聚技术组合潜力测度框架,以专利IPC分类共现形成的技术组合作为分析单元,运用熵权法确定各指标权重,形成可量化的技术组合潜力评价模型,并以自动驾驶领域为研究对象开展实证研究。
[结果/结论]
研究发现,技术融合性与技术新颖性在会聚技术组合演化过程中呈现协同效应,二者的综合测度结果能够有效区分不同潜力层级的技术组合,高潜力会聚技术组合在技术扩散能力方面表现更为突出。
Select
研究论文
面向政务服务场景的智能问答能力测评基准研究
黄钰婷, 邵扶天, 宋姗姗, 黄璜
2026, 70(21): 49-59.
https://doi.org/10.13266/j.issn.0252-3116.2026.21.004
摘要
(
)
PDF全文
(
)
可视化
收藏
[目的/意义]
针对当前政务智能问答系统评测中存在的可复现性弱、多模态响应评估难等关键问题,基于基准测试理念,融合大语言模型与机器学习技术,构建一套适用于政务场景的标准化评测题集及自动化评估框架,以支持系统性能的科学量化与持续优化。
[方法/过程]
通过系统收集与清洗政务热点问题,形成高质量初始问题集;利用自动化流程获取代表性政务问答系统的真实回复,并融合大语言模型语义理解与传统特征提取方法,生成可用于自动化判断的答案关键词集;最终构建包含多领域政务主题的标准化评测题库,并基于此对我国省级政务智能问答系统开展批量测试与量化评估。
[结果/结论]
实验结果表明,所提出的自动化评测方法与人工评价结果之间具有显著一致性,秩相关系数达0.77。经10轮实测与回归外推,27轮以内评测结果离散度可保持在5%以内,展现出良好的稳健性与可复现性。该基准测试方法具备较强的通用性与扩展性,不仅可用于系统间横向对比,还能有效追踪系统在小版本迭代中的性能变化,可以为提升政府在线问答服务质量提供可行的评测工具与参考依据。
Select
研究论文
基于LLM检索重排和查询优化的医疗查询意图识别研究
韩普, 刘森嶺
2026, 70(21): 60-70.
https://doi.org/10.13266/j.issn.0252-3116.2026.21.005
摘要
(
)
PDF全文
(
)
可视化
收藏
[目的/意义]
为解决用户查询语义模糊、结构不完整等问题,提升医疗查询意图识别效果,提出一种基于LLM检索重排和查询优化的意图识别方法RRQ-LMIR。
[方法/过程]
首先利用混合检索策略从外部知识库中获取和用户原始查询语义相近的候选示例,接着通过构建结构化提示信息引导LLM对候选结果进行语义相关度重排序,然后基于重排序结果利用LLM生成语义更清晰、结果更完整的优化查询,最后采用微调后的深度学习模型对初始查询和优化查询进行意图分类,并通过等权重加权融合策略获得最终预测结果。
[结果/结论]
实验结果表明,构建的医疗查询意图识别方法RRQ-LMIR的F1值达到84.30%,相比当前主流的深度学习模型RoBERTa-wwm-ext和大语言模型GPT-5分别提高3.26%和22.7%。所提方法可以有效解决用户查询语义模糊、结果不完整等问题,能够提升医疗查询意图识别效果。
Select
研究论文
面向药物知识发现的大语言模型多阶段知识抽取框架研究
康宏宇, 李姣, 李勤, 侯丽
2026, 70(21): 71-82.
https://doi.org/10.13266/j.issn.0252-3116.2026.21.006
摘要
(
)
PDF全文
(
)
可视化
收藏
[目的/意义]
旨在探索如何通过多阶段策略激发大语言模型的知识抽取能力,突破通用模型在专业场景中的性能瓶颈,为医药领域的知识组织、知识抽取与知识发现提供可复制路径。
[方法/过程]
构建涵盖12类实体与26类关系的药物知识组织框架,结合提示工程生成专业领域语料。通过融合弱监督训练、强监督微调与反思优化的三阶段策略(Multi-KE),逐步提升大语言模型在特定领域知识抽取上的性能表现和可解释性。开展基于知识图谱的多跳路径发现,验证模型在药物作用机制挖掘与潜在适应症发现中的应用价值。
[结果/结论]
在PubMed数据集上,Multi-KE在实体及关系抽取中的F1值分别达到82.20%和65.54%,较通用大模型GPT-4o、LLaMA3-8B提升明显(分别提升20.32%、34.53%和29.47%、47.97%),仅略低于DeepSeek-R1(低2.44%、3.48%)。同时,较专用领域大模型OpenBioLLM-70B提升幅度达到22.54%和35.49%。此外,利用ADE-Corpus-V2数据集验证了模型的泛化能力,利用消融实验验证了三阶段策略对性能提升均有贡献,借助数据分布和错误分析深入探讨模型在低频实体识别与复杂关系抽取中的表现与局限。通过对知识抽取过程的可追溯记录以及反思优化机制的引入,实现了模型决策路径的透明化与可解释性提升。通过知识图谱多跳路径分析,验证了知识抽取框架在支持药物–疾病潜在关联识别及复杂药理机制分析方面的有效性。
Select
研究论文
基于知识基因的颠覆性技术识别方法研究——以太阳能光伏领域为例
胡雅敏, 韩芳, 袁军鹏
2026, 70(21): 83-99.
https://doi.org/10.13266/j.issn.0252-3116.2026.21.007
摘要
(
)
PDF全文
(
)
可视化
收藏
[目的/意义]
为改进当前颠覆性技术识别侧重结构特征、 内容知识精细度不足的问题, 引入并优化知识基因方法, 构建基于知识基因的颠覆性指数(GD), 以提升识别的精准度与细粒度。
[方法/过程]
首先, 改进知识基因提取公式, 在专利文献中解析出多元知识基因实体; 其次, 计算每篇专利的GD指数; 最后以太阳能光伏领域专利为例进行实证分析, 并与传统颠覆性创新指数D、 DI5指数进行对比。
[结果/结论]
提取的太阳能光伏领域知识基因涵盖电池材料、 结构设计等关键技术; GD指数对技术突破性的识别敏感性高于D/DI5指数, 能有效筛选出多项颠覆性技术和行业核心创新主体; 基于GD指数的方法可在知识层面细粒度揭示专利颠覆性, 在知识交叉性强的技术评价中更具优势。
Select
研究论文
关联结构—语义的细分主题识别与多维特征研究
王康, 张鑫, 刘启巍, 崔林蔚
2026, 70(21): 100-120.
https://doi.org/10.13266/j.issn.0252-3116.2026.21.008
摘要
(
)
PDF全文
(
)
可视化
收藏
[目的/意义]
构建一种融合结构特征与语义内涵的关联模型, 实现对知识领域细分主题的精准识别, 同时揭示细分主题交叉性、 突现性和新颖性特征之间关系的动态演变, 为深度理解领域的研究基础、 发展趋势及内在动力提供理论与方法支撑。
[方法/过程]
首先基于文献共被引网络进行聚类结构划分, 识别宏观基础主题; 其次根据引用关联度筛选出各聚类结构的施引文献, 利用改进的BERTopic主题模型实现细分主题的识别和交叉论文的多主题归属划分; 再次构建交叉性、 突现性和新颖性指标, 实现细分主题的多维特征计算; 最后分阶段对各细分主题的交叉性、 突现性和新颖性指标进行相关分析, 揭示科学研究发展的演变规律。
[结果/结论]
以区块链领域为例进行案例研究, 研究发现: ①区块链领域宏观主题分为6个大类, 其扩展到的施引文献主题分为56个细分主题, 其中有7 868篇交叉论文被划分到不同细分主题中; ②区块链领域正经历显著的转型和扩展, 交叉性主题呈现出显著的稳定性, 突现性和新颖性主题变化较为明显, 三个指标均较高的突破性创新主题是区块链+人工智能和隐私保护; ③主题交叉性、 突现性、 新颖性指标相关性变化表明该领域经历了从早期以基础性、 范式级、 跨界创新为核心驱动(指标强耦合), 到中期应用/炒作驱动(突现性与新颖性耦合, 与交叉性解耦), 再到当前多元化、 专业化、 理性化发展(指标间普遍解耦) 的演变过程。
Select
研究论文
大宗交易困境下国内图书馆电子资源精准采购策略研究——基于Unsub评估工具的分析
朱一真, 张敏, 叶青云, 王乐
2026, 70(21): 121-132.
https://doi.org/10.13266/j.issn.0252-3116.2026.21.009
摘要
(
)
PDF全文
(
)
可视化
收藏
[目的/意义]
探索电子资源的精准采购策略,可为图书馆应对传统大宗交易采购模式导致的成本高、经费压力大等问题提供有效路径。
[方法/过程]
引入Unsub工具,通过量化电子资源使用效益(如下载量、引用频次、开放获取比例)与成本效益(NCPPU模型)进行实证分析,通过两个案例讨论改变图书馆电子资源大宗交易模式的可能性。
[结果/结论]
研究发现,大宗交易模式会导致图书馆资源浪费,Unsub能够为图书馆精准化资源采购提供良好的决策参考。最后基于分析结果对国内图书馆精准采购以及图书馆联盟集团采购的优化提出更符合自身需求的可持续发展建议。
Select
研究论文
高校专利转移数据失真的内在逻辑与生成机理解析——基于扎根理论
吴红, 代小雨, 王萍
2026, 70(21): 133-143.
https://doi.org/10.13266/j.issn.0252-3116.2026.21.010
摘要
(
)
PDF全文
(
)
可视化
收藏
[目的/意义]
专利转移统计数据是衡量高校专利工作绩效的重要依据。对多元实践主体的调研揭示,当前统计体系背后存在着系统性数据失真现象。深入揭示数据失真的具体表现及生成机理,对优化激励政策、推动专利转移回归技术应用本质具有重要意义。
[方法/过程]
基于扎根理论,通过半结构化的访谈获得原始资料,采用多轮编码对影响因素进行关系梳理,构建数据失真现象理论模型,剖析各因素间的作用关系。
[结果/结论]
研究发现,数据失真主要表现为非正常转移目的和变相转移路径,由激励政策弊病、高校内部阻力和专利价值偏低交互作用,通过直接因果或中介作用促成。据此,建议重构突出专利使用性和落地性的转移统计逻辑,改革高校激励与管理机制,提升对不同转移模式的包容性。
Select
研究论文
知识流动视域下公共图书馆国际交流赠书实践研究——以上海图书馆“上海之窗”项目为例
汤旎, 刘贝玲
2026, 70(21): 144-157.
https://doi.org/10.13266/j.issn.0252-3116.2026.21.011
摘要
(
)
PDF全文
(
)
可视化
收藏
[目的/意义]
以“上海之窗”项目为例,研究公共图书馆国际赠书活动中境外图书馆赠书遴选行为所呈现的知识流动现象,探讨国际交流赠书活动中知识流动机制与再生产路径。
[方法/过程]
使用Python进行单因素方差分析、事后多重比较、K-means算法并绘制桑基图,对2014—2024年间59个国家127家境外图书馆的赠书遴选数据进行整体流向、主题流向、语种流向分析,并进行聚类。
[结果/结论]
国内赠出馆的赠书供给机制与境外受赠馆的情景需求差异及制度放大效应相互作用,共同影响知识流动的效率与深度。而设计画像簇驱动的赠书遴选前馈机制,则有助于动态应对需求势差及供需精准匹配。赠书一旦落地,受赠馆可通过策展、教育、活动等方式,完成知识的再生产。本文为公共图书馆提升国际交流赠书活动效能提供了可借鉴的模式,同时为中华文化对外传播贡献了基于知识流动范式的图书馆循证路径。
简讯
Select
简讯
人工智能时代“知识的螺旋”:2026知识管理与知识创新学术研讨会征文及会议通知(第二轮)
2026, 70(21): 158-160.
摘要
(
)
PDF全文
(
)
可视化
收藏
更多文章
更多文章
更多文章
更多文章
更多文章
E-mail Alert